Боты Google: какие бывают и как работает Google-Extended
 Виталий Грот
Google использует разных ботов и загрузчиков для поиска, изображений, Shopping, Gemini и действий по запросу пользователя. Разбираем Googlebot, Google-Extended, Google-Agent и другие имена: что каждый делает, чем управляется в robots.txt и как проверить обращения в логах.
Решаем проблему: понять, какой доступ оставить Google для поиска и ИИ, а какой ограничить без случайной блокировки сайта.
Короткий ответ: это не один бот
Google использует несколько групп автоматических клиентов. Основной поисковый робот — Googlebot. Есть специализированные сканеры изображений, видео, Google News, Shopping и рекламы, а также загрузчики, которые обращаются к URL после действия пользователя. В документации Google разделяет общих сканеров, сканеры особых случаев и загрузчики, вызванные пользователем (список общих сканеров, список специальных сканеров, пользовательские загрузчики).
Главное для владельца сайта — разделять три задачи:
- **Поиск и индексация.** Googlebot получает страницу, а системы поиска решают, добавлять ли её в индекс и показывать ли в Google Search.
- **Использование контента в Gemini.** Google-Extended — токен для robots.txt, который управляет некоторыми способами использования контента для обучения Gemini и grounding — получения сведений из поискового индекса при подготовке ответа.
- **Загрузка по действию человека.** Google-Agent или Gemini Notebook могут запросить конкретную страницу, когда пользователь попросил продукт перейти по ссылке или использовать её как источник.
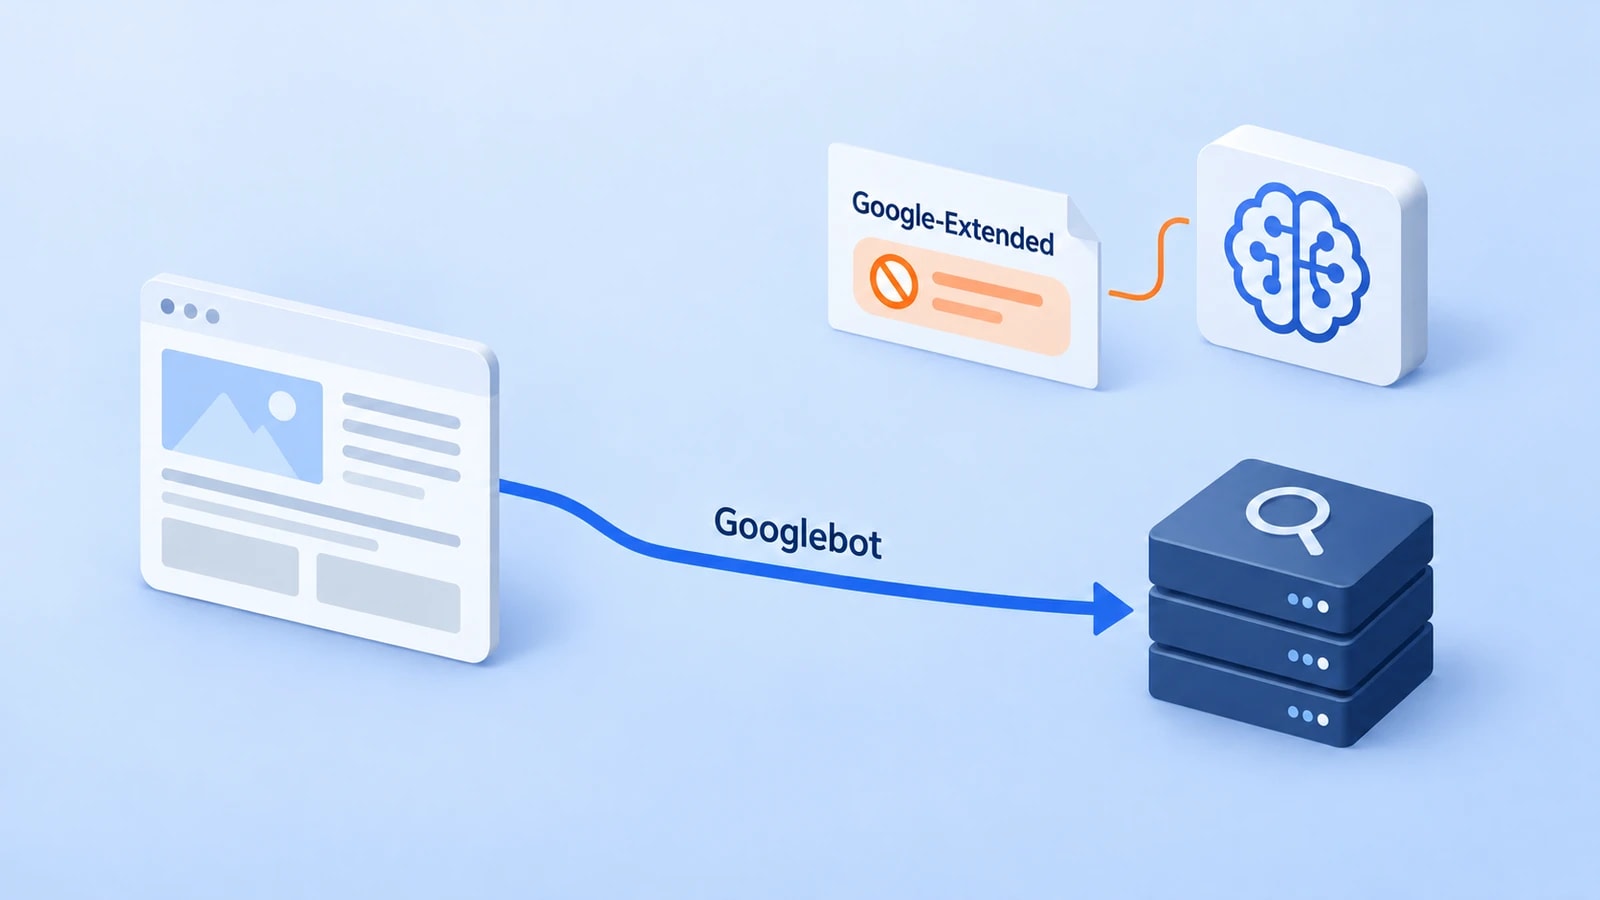
Схема показывает разные функции и управляющие правила, а не три независимые копии страницы. В частности, Google-Extended не выдаёт себя за отдельный HTTP-робот и не создаёт отдельную строку в логах сайта.
Google-Extended — не отдельный бот с собственным User-Agent. Это токен управления для robots.txt; сетевые запросы выполняются с уже существующими Google User-Agent.
Googlebot и сканеры для поиска
У Googlebot есть мобильный и настольный варианты. Для большинства сайтов Google Search преимущественно индексирует мобильную версию, поэтому большинство запросов Googlebot приходит с мобильным User-Agent. При этом в robots.txt обе версии регулируются одной группой User-agent: Googlebot; выборочно разрешить смартфон и запретить компьютер этим правилом нельзя (документация Googlebot).
| Имя или токен | Для чего нужен | Что важно в настройке |
|---|---|---|
| `Googlebot` | Основной обход Google Search: поиск, Discover и другие функции Search | Блокировка влияет на весь Google Search, включая AI-функции в поиске |
| `Googlebot-Image` | Получение изображений для Google Images и функций поиска, где показываются изображения | Может влиять на изображения, логотипы и значки в поверхностях Google |
| `Googlebot-Video` | Получение видео для функций Google Search и связанных видеопродуктов | Отдельный токен нужен, если управлять доступом к видео отдельно от страниц |
| `Googlebot-News` | Правило для продукта Google News | Отдельного HTTP User-Agent с таким именем нет; используется обычная строка Googlebot |
| `Storebot-Google` | Обход для поверхностей Google Shopping | Не путать со сканированием обычных страниц для основного поиска |
| `Google-InspectionTool` | Инструменты проверки, например URL Inspection и Rich Results Test | Правило не управляет индексированием в Google Search |
Что происходит после запроса Googlebot
Запись в логе подтверждает запрос к URL. Получил ли клиент содержимое страницы, проверяют по коду и содержанию ответа. Запрос сам по себе не доказывает попадание страницы в индекс и тем более её позицию. В Google Search JavaScript-страницы проходят три основных этапа: обход, рендеринг и индексирование. Googlebot находит адреса прежде всего по ссылкам на уже известных страницах; sitemap помогает сообщить о URL, но не гарантирует обход. Перед HTTP-запросом Googlebot проверяет robots.txt. Для доступной страницы Google может отдельно запустить рендеринг в Chromium и использовать полученный HTML при индексировании (как Google обрабатывает JavaScript, как Googlebot обнаруживает URL, зачем нужна карта сайта).
| Этап | Что делает Google | Что проверить владельцу сайта |
|---|---|---|
| Обнаружение | Берёт ссылки из известных страниц; может найти адрес из sitemap | Внутренние ссылки открываются через обычные <a href>; sitemap доступен и содержит нужный URL |
| Обход | Запрашивает URL, предварительно проверив правила robots.txt | Код ответа, цепочки редиректов, доступность CSS и JavaScript, ограничения CDN/WAF |
| Рендеринг | Для доступной JavaScript-страницы может выполнить код в Chromium и получить отрисованный HTML | Видны ли основной текст, ссылки и директивы в итоговом HTML |
| Индексирование | Системы Google обрабатывают страницу и решают, включать ли её в поиск | Страница доступна для обхода, не закрыта noindex, canonical согласован; включение не гарантировано |
Токен Googlebot-News влияет на Google News и приложение Google News. Он не управляет вкладкой «Новости» в обычной выдаче Google Search: Google исправил это описание в документации в 2025 году. Сканер и токен — не всегда одно и то же имя: Google News сканирует стандартный Googlebot, а отдельное правило определяет применение контента в продукте Google News (список общих сканеров и их назначение, журнал изменений документации).
Если закрыть Googlebot, это ограничит не только обычные результаты, но и другие функции Google Search. Не добавляйте Disallow: / для Googlebot, когда задача — лишь запретить использование страниц для обучения Gemini.
Google-Extended: что он разрешает и ограничивает
Google-Extended — самостоятельный продуктовый токен, который издатель указывает в robots.txt. У него нет своего HTTP User-Agent: Google выполняет запросы с обычными идентификаторами Google, а токен сообщает, разрешено ли использовать полученный контент для конкретных AI-задач.
По документации Google, правила Google-Extended позволяют управлять тем, может ли контент, полученный Google с сайта, использоваться для **обучения будущих моделей Gemini** и для некоторых видов **grounding** в Gemini Apps и Gemini на Vertex AI. Grounding в этом контексте — когда модель использует данные из индекса Google Search, чтобы сделать ответ точнее и актуальнее. Google отдельно указывает, что Google-Extended не влияет на присутствие сайта в Google Search и не используется как сигнал ранжирования (официальное описание Google-Extended).
| Если добавить правило | Что оно регулирует | Чего оно не делает |
|---|---|---|
| `User-agent: Google-Extended` + `Disallow` | Ограничивает описанные Google способы использования охваченных URL для обучения Gemini и grounding | Не удаляет URL из Google Search и не меняет позицию страницы в поиске |
| `User-agent: Googlebot` + `Disallow` | Запрещает Googlebot получать закрытые пути для Google Search и других поверхностей, зависящих от него | Не гарантирует удаление уже известного URL из индекса |
| `noindex` для Googlebot | Просит убрать доступную Googlebot страницу из поискового индекса | Не запрещает само получение страницы для чтения правила и не заменяет защиту входом |
Важное различие — между Google AI в поиске и приложением Gemini. AI Overviews и AI Mode являются функциями Google Search и используют системы поиска и его индекс. Google указывает, что для этих AI-функций по-прежнему важны базовые требования SEO и доступность материала в Search. Поэтому вывод из опубликованных правил такой: Google-Extended не является переключателем видимости в AI Overviews; блокировка Googlebot влияет на функции Google Search, в том числе AI Search (руководство Google по AI-функциям поиска, описание влияния Googlebot). Это вывод из границ, которые Google описывает для двух разных систем управления.
Запрет Google-Extended — не настройка «убрать сайт из всех ответов ИИ Google». Он касается перечисленных Google способов использования контента в Gemini; доступность страниц для AI Overviews и AI Mode относится к Google Search.
Другие сканеры, связанные с продуктами Google
Не каждый запрос Google относится к поисковой выдаче. Часть клиентов получает контент для определённого сервиса или выполняет техническую проверку.
| Идентификатор в User-Agent или токен robots.txt | Назначение | Типичная ситуация |
|---|---|---|
| `GoogleOther` | Универсальный сканер для общедоступных материалов; может использоваться командами Google для разовых исследований и разработки | Запрос есть в логах, но он не соответствует поисковой индексации |
| `GoogleOther-Image`, `GoogleOther-Video` | Варианты GoogleOther, оптимизированные для получения публичных файлов изображений и видео | Отдельные загрузки медиафайлов |
| `Google-CloudVertexBot` | Сканирование по запросу владельца сайта при создании Vertex AI Agents | Команда настраивает агента в Vertex AI |
| `AdsBot-Google`, `AdsBot-Google-Mobile` | Проверка посадочных страниц в Google Ads | Проверяется качество целевой страницы рекламы |
| `Mediapartners-Google` | Получение страниц для рекламных продуктов, включая AdSense и Ad Manager | На сайте показывается контекстная реклама |
| `APIs-Google` | Доставка push-уведомлений Google APIs | Сервис отправляет уведомления через API Google |
| `Google-Safety` | Специальный обход для поиска злоупотреблений, например вредоносных ссылок, опубликованных в сервисах Google | Игнорирует robots.txt; это механизм безопасности, а не обычная индексация |
Для части таких клиентов действует отдельная robots.txt-группа. В частности, AdsBot-Google, AdsBot-Google-Mobile, Mediapartners-Google и APIs-Google могут игнорировать общую группу User-agent: *; настраивать нужно собственное имя агента. Некоторые специальные сканеры Google могут игнорировать robots.txt полностью. Это зависит от продукта и договорённостей с владельцем сайта, поэтому проверьте назначение конкретного клиента в документации специальных сканеров Google.
GoogleOther сам по себе не подтверждает, что страница использовалась Gemini: Google описывает его как общий сканер без привязки к отдельному продукту. Поэтому не следует трактовать каждое посещение GoogleOther как попытку обучения модели. А Google-CloudVertexBot нельзя смешивать с Google-Extended: первый выполняет сканирование для агента, которого настроил владелец сайта; второй задаёт правила использования материала в определённых задачах Gemini.
Gemini Notebook и Google-Agent: запрос по инициативе пользователя
В группе пользовательских загрузчиков Google выделяет клиентов, которые обращаются к конкретным URL после действия человека. Это не тот же процесс, что автоматический обход всего сайта для индекса.
| Идентификатор в User-Agent | Что загружает | Что полезно знать |
|---|---|---|
| `Google-GeminiNotebook` | URL, который человек добавил как источник в Gemini Notebook | Новое имя опубликовано 16 июля 2026 года; старый идентификатор Google-NotebookLM поддерживался до августа 2026 года |
| `Google-Agent` | Страницы для навигации и действий Google-агента по запросу человека | Это пользовательский агент, а не робот, который автоматически индексирует весь сайт |
| `Google-Read-Aloud` | Страницу, которую пользователь попросил озвучить | Запрос связан с функцией чтения вслух |
| `Google-Pinpoint` | URL, добавленные пользователем как источники в Pinpoint | Загружаются отдельные адреса, а не весь сайт |
| `GoogleMessages` | Страницу для предпросмотра ссылки в Google Messages | Обращение нужно для карточки ссылки в чате |
Google предупреждает, что пользовательские загрузчики обычно игнорируют robots.txt, потому что URL запросил человек. Для страниц, которые нельзя показывать без разрешения, нужен контроль доступа на сервере: пароль, авторизация или другой механизм. robots.txt сообщает предпочтения для обхода, но не защищает секретные материалы от прямого открытия (документация пользовательских загрузчиков).
Если URL должен быть конфиденциальным, не полагайтесь на robots.txt и на запрет Google-Extended. Закройте материал авторизацией: публичную страницу пользовательский загрузчик может открыть по прямой ссылке.
Как управлять Google через robots.txt
robots.txt выбирает, какие URL может запрашивать конкретная группа роботов. Группа Googlebot нужна для поискового обхода, группа Google-Extended — для управления описанными выше способами использования материалов Gemini.
User-agent: Googlebot
Allow: /
Disallow: /search/

User-agent: Google-Extended
Disallow: /ai-excluded/
Важно: Google применяет к роботу самую конкретную подходящую группу. Правила группы User-agent: * не добавляются к отдельной группе User-agent: Googlebot. Поэтому перед добавлением такой группы проверьте прежние запреты: если они должны сохраниться, повторите их в группе Googlebot. Иначе Allow: / может открыть Googlebot пути, которые были закрыты только общей группой (как Google выбирает группы правил).
В этом примере Googlebot может сканировать сайт, кроме пути /search/. Google-Extended не должен использовать путь /ai-excluded/ в целях, которые Google связывает с этим токеном. Для запрета таких способов на всём сайте правило будет выглядеть так:
User-agent: Google-Extended
Disallow: /
Не добавляйте такое правило, пока не решили, хотите ли ограничить обучение и grounding Gemini для всех публичных страниц. Оно не закрывает страницы от Google Search.
Если страницу нужно исключить из поиска, правило noindex должно быть доступно Googlebot: в <meta name="robots" content="noindex"> или HTTP-заголовке X-Robots-Tag. Не закрывайте одновременно URL в robots.txt, иначе Googlebot не сможет получить страницу и увидеть noindex. Удаление адреса из поиска и блокировка сканирования — разные задачи (как работает noindex, спецификация robots.txt Google).
Disallow в robots.txt — не команда удалить URL из индекса. Если Google уже знает адрес по ссылкам, он иногда может показать сам URL без описания. Для удаления из поиска используйте доступный Googlebot noindex, а для приватных данных — авторизацию.
Как выбрать правило
Для большинства публичных сайтов отправная точка — не мешать Googlebot получать полезные страницы, а решения по Google-Extended принимать отдельно. На адресах с личными кабинетами и данными клиентов сначала настраивают серверную авторизацию, затем проверяют правила сканирования.
| Цель | Что проверять | Типичное решение |
|---|---|---|
| Страница должна появляться в поиске | Доступность URL, ответ сервера, robots.txt, canonical | Не блокировать Googlebot; проверить страницу через Search Console |
| Страницу нужно убрать из выдачи | Не закрыт ли URL от обхода до чтения директивы | Добавить noindex, оставить Googlebot доступ до обработки |
| Материал не должен использоваться для целей Google-Extended | Совпадает ли путь с нужной частью сайта | Добавить отдельную группу Google-Extended в robots.txt |
| Документ должен быть доступен только клиентам | Можно ли открыть URL без входа | Включить авторизацию; robots.txt не использовать как замок |
| Неясно, кто создаёт нагрузку | User-Agent, IP, URL, код и объём ответа в логах | Сначала подтвердить, что это запрос Google, затем смотреть правила CDN/WAF |
Как проверить, что бот настоящий
Строку User-Agent легко скопировать. Запрос с надписью Googlebot в логе ещё не доказывает, что его отправил Google. При ручной DNS-проверке выполните обратный поиск IP и проверьте, что имя равно googlebot.com, google.com или googleusercontent.com либо оканчивается на .googlebot.com, .google.com или .googleusercontent.com — точка перед доменом обязательна. Затем выполните прямой поиск этого имени и убедитесь, что он возвращает исходный IP. Для автоматической проверки можно сверить адрес с официальными диапазонами Google (инструкция Google по проверке запросов).
Проверяйте запрос по нескольким полям:
- **User-Agent:** какой токен указан и к какому классу Google он относится.
- **IP:** входит ли адрес в диапазоны Google для этого вида сканера или загрузчика.
- **URL и время:** какие страницы и ресурсы запрашивались; повторяется ли ошибка.
- **Ответ сервера:** код HTTP, цепочка редиректов, длительность, объём ответа.
- **robots.txt и CDN/WAF:** не блокирует ли доступ правило сайта или защитный фильтр.
- **Результат обработки:** для Googlebot — отчёт статистики сканирования и проверка URL в Search Console.
В Search Console отчёт Crawl Stats отражает активность Googlebot. Он не является журналом всех пользовательских fetcher-ов и не показывает, что Google использовал конкретную страницу для обучения Gemini. Google-Extended не имеет отдельного HTTP User-Agent, поэтому его нельзя надёжно «отфильтровать» по самостоятельной строке в access log.
Если в логах появился неожиданный Google-Agent или Gemini Notebook, не блокируйте IP только по тексту User-Agent. Сверьте запрос с официальными списками IP и правилами продукта. Пользовательские загрузчики могут обойти robots.txt именно потому, что действуют по запросу человека.
Что подчёркивают англоязычные SEO-разборы
В англоязычных SEO-разборах Search Engine Land об AI-crawler-ах и Ahrefs о Googlebot ботов полезно делят по функции: поиск, специальные продуктовые задачи, обучение моделей и загрузка по запросу человека. Это помогает выбрать правило robots.txt по цели. Но коммерческие списки быстро устаревают: в материале Search Engine Land ещё используется старое имя Google-NotebookLM, а Google переименовал агент в Google-GeminiNotebook в июле 2026 года. Актуальное название и область действия сверяйте с официальным журналом изменений Google.
Практический вывод из этих разборов: не считать визит одного агента доказательством цитирования сайта или попадания материала в обучение. User-Agent помогает распознать тип запроса, но не раскрывает, как конкретная страница была обработана продуктом; сам токен Google-Extended, в отличие от обычного User-Agent, невозможно искать в access log как отдельного клиента.
Список Google меняется. Например, в 2026 году Google добавил Google-Agent и переименовал загрузчик NotebookLM в Google-GeminiNotebook; официальная документация также обновила детали Googlebot-News и другие описания. Поэтому перед массовым изменением robots.txt проверяйте текущие имена в документации Google, а не только в старых статьях и списках SEO-инструментов.
Частые ошибки
| Ошибка | Почему опасно | Что делать |
|---|---|---|
| Считать Google-Extended отдельным HTTP-ботом | Его нельзя увидеть как самостоятельный User-Agent | Управлять токеном Google-Extended в robots.txt |
| Блокировать Googlebot ради запрета обучения Gemini | Блокировка задевает Google Search и его AI-функции | Использовать отдельный Google-Extended, если цель именно в ограничении Gemini |
| Считать robots.txt защитой личных данных | Запрет обхода не мешает человеку открыть публичный URL | Включить авторизацию или убрать конфиденциальный файл из открытой сети |
| Удалять страницу из выдачи через Disallow | Googlebot не прочитает директиву noindex на запрещённой странице | Разрешить обход и отдать noindex |
| Верить любой строке Googlebot в логах | User-Agent подделывают | Сверить IP и reverse/forward DNS по правилам Google |
| Считать каждое посещение GoogleOther запросом Gemini | GoogleOther не закреплён за конкретным продуктом | Сопоставить запрос с документацией конкретного агента |
Вопросы и ответы
Нет. Google указывает, что токен Google-Extended не влияет на включение сайта в Google Search и не используется как сигнал ранжирования. Он управляет описанными Google способами использования материалов для Gemini.
Сам запрет Google-Extended не препятствует появлению сайта в AI Overviews. Google относит AI Overviews и AI Mode к функциям Google Search, которые опираются на поисковый индекс. Но появление сайта в AI Overviews не гарантировано.
Нет как отдельный HTTP User-Agent. Это robots.txt-токен, применяемый к контенту, который Google получает под существующими именами Google User-Agent.
Нет. В robots.txt есть токен `Googlebot-News`, но Google указывает, что отдельной строки HTTP User-Agent для него нет: обход выполняют варианты Googlebot. Токен управляет применением контента в Google News.
Это агент Google, который может открывать страницы и выполнять действия по пользовательскому запросу. Google относит его к пользовательским fetcher-ам, а не к автоматическому поисковому обходу всего сайта.
Не блокируйте Googlebot. Добавьте отдельную группу `User-agent: Google-Extended` с нужным `Disallow`; сначала проверьте, какие пути должны оставаться доступными для поиска.
Нет, запрет обхода сам по себе не гарантирует исключение URL из выдачи. Для удаления используйте доступную Googlebot директиву `noindex`; конфиденциальные данные закрывайте авторизацией.
Что проверить сначала
Сначала определите цель: индексация в Google Search, использование материалов в Gemini или загрузка конкретной страницы по запросу человека. После этого проверьте отдельную группу robots.txt, реальные ответы сервера и подлинность запросов по IP. Не меняйте правила для Googlebot, если нужно управлять только Google-Extended.
Смотреть источникиСкрыть источники
- https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers
- https://developers.google.com/crawling/docs/crawlers-fetchers/google-special-case-crawlers
- https://developers.google.com/crawling/docs/crawlers-fetchers/google-user-triggered-fetchers
- https://developers.google.com/search/docs/crawling-indexing/googlebot
- https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics
- https://developers.google.com/search/docs/crawling-indexing/sitemaps/overview
- https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
- https://developers.google.com/crawling/docs/crawlers-fetchers/verify-google-requests
- https://developers.google.com/search/docs/crawling-indexing/block-indexing
- https://developers.google.com/crawling/docs/robots-txt/robots-txt-spec
- https://developers.google.com/crawling/docs/changelog
- https://searchengineland.com/guide/ai-crawlers
- https://ahrefs.com/blog/googlebot/
ИИ-боты: кто обходит сайт, где найти IP и кого разрешать
Как закрыть сайт от ботов и сохранить доступ поисковикам и ИИ
Ложные срабатывания AntiBot.Cloud: как вернуть доступ поисковикам и полезным ботам
llms.txt: что это, как создать файл и нужен ли он для GEO