Как сайт попадает в ответы ChatGPT, Claude, Gemini и Perplexity: GEO простыми словами
Нейросеть может читать ваш сайт каждый день и при этом рекомендовать пользователю конкурента. Это не сбой и не недоработка — так устроена система: найти хороший источник и назвать хороший бренд для неё две разные задачи, и решает она их по разным сигналам. Отсюда главная ошибка в разговорах про GEO: видимость меряют попаданием в источники, а деньги приносит только последняя ступень — рекомендация. Разбираю, из чего складывается видимость в ответах ИИ, что из этого делается на своём сайте, а что вне его, и как это мерить, чтобы не обманываться.
GEO и SEO решают разные задачи
Классическое SEO отвечает на вопрос «как поднять страницу в выдаче». GEO — Generative Engine Optimization — на другой: как сделать, чтобы нейросеть нашла информацию, использовала её и назвала бренд. Тем же явлением называют AEO, LLM Optimization и AI Visibility; термин не устоялся, суть одна.
| SEO | GEO | |
|---|---|---|
| Цель | Позиция страницы | Присутствие в ответе |
| Результат | Ссылка в списке | Цитата, упоминание, рекомендация |
| Единица работы | Страница | Ответ, собранный из многих источников |
| Что видит человек | Список сайтов | Готовый ответ |
| Переход на сайт | Смысл всей работы | Может не случиться вовсе |
| Стабильность | Позиции держатся | Ответ меняется от формулировки запроса |
GEO не отменяет SEO, а стоит на нём. Страница, недоступная роботу, не станет источником оттого, что текст на ней написан красиво.
Три разных механизма за фразой «попал в ChatGPT»
| Механизм | Что происходит | Что вы можете сделать |
|---|---|---|
| Знания модели | Информация усвоена при обучении и лежит в весах | Почти ничего: обучение прошло без вас |
| Retrieval | Система достаёт документы из своей базы и кладёт их модели в контекст | Быть в этой базе и быть удобным для извлечения |
| Веб-поиск | Модель формулирует поисковые запросы, читает найденное и отвечает со ссылками | Обычная поисковая видимость и техническая доступность |
Три события, одна фраза. Когда вам говорят «мы попали в ChatGPT», сначала выясните, о каком из трёх речь: работа под них разная.
Четыре ступени видимости, и они не равны
- Извлечение. Ваша страница попала в набор источников, по которым собирался ответ.
- Цитирование. Пользователь увидел ссылку на вас.
- Упоминание бренда. В тексте ответа прозвучало название компании или продукта.
- Рекомендация. Модель прямо предложила вас как решение задачи.
Коммерческий смысл живёт на четвёртой ступени, а меряют обычно первую — потому что её проще всего увидеть. Между ними разрыв, который не закрывается объёмом контента.
Разбор Kimi: читают активно, рекомендуют слабо
Аналитик Дэвид Коницны разобрал контент-стратегию Kimi — китайского ИИ-ассистента от Moonshot. Наблюдение: вокруг запуска новой модели на сайте пакетами вышли сотни инструкций и статей-списков сразу на нескольких языках. Дальше он прогонял запросы через ChatGPT, Claude, Gemini и Perplexity и смотрел, что происходит.
Свежие страницы действительно начали попадать в источники — за недели, а не месяцы. Но вывод автора звучит так: попасть в источники и быть рекомендованным как бренд — разные вещи. Retrieval вырос, а рекомендации за ним не пошли.
Точных цифр этого разбора я не привожу: подробная выкладка лежит в закрытой для меня статье, и перепечатывать чужие проценты как проверенный факт нельзя. Проверяемая часть — сам вывод и метод: сотни страниц пакетами, несколько языков, замер по четырём системам.
Механика за этим простая. Чтобы взять ваш текст в источники, модели достаточно, что он понятный и по делу. Чтобы назвать вас в ответе, ей нужны другие сигналы: независимые упоминания, обзоры, рейтинги, отзывы, согласованность данных о компании в разных местах. Первое вы пишете сами. Второе — про вас пишут другие.
Своё и чужое: два слоя работы
| Слой | Что делаете | Какую ступень двигает |
|---|---|---|
| Свой сайт | Инструкции, разборы, FAQ, сравнения, документация, собственные данные | Извлечение и цитирование |
| Внешние источники | Отраслевые площадки, обзоры, рейтинги, каталоги, сообщества, СМИ | Упоминание и рекомендация |
Работать только с первым слоем — это ровно ситуация Kimi: нейросеть кормится вашим текстом и рекомендует того, о ком пишут другие.
Техника: сначала доступность, потом текст
OpenAI формулирует условие прямо: в поиск ChatGPT может попасть любой публичный сайт, но чтобы контент нашли, показали и корректно сослались, нельзя блокировать OAI-SearchBot. Это отдельный робот, и запрет ему в robots.txt закрывает вопрос до всякого контента.
- Откройте robots.txt и найдите ботов ИИ
OAI-SearchBot отвечает за поиск ChatGPT, GPTBot — за обучение, это разные вещи и решения по ним разные. Заодно проверьте, не режет ли ботов ваш антибот или CDN: запрет на уровне сервера в robots.txt не виден.
- Проверьте, что страница отдаётся без скриптов
Запросите её как робот и посмотрите, есть ли в ответе текст. Контент, который дорисовывается JavaScript, для части систем не существует.
- Проверьте разметку смысла
Заголовки по иерархии, таблицы таблицами, а не картинками, стабильный адрес, внутренние ссылки на важные страницы. Извлечению нужен кусок с понятными границами, а не сплошное полотно.
Как писать, чтобы вас было удобно цитировать
Извлекающая система берёт из страницы фрагмент, а не читает её целиком. Значит выигрывает текст, у которого ответ отделён от подводки.
«В современном мире, когда технологии развиваются стремительными темпами, всё больше компаний задумываются о происхождении цифрового контента…»
«C2PA — открытый стандарт, который прикладывает к файлу криптографически подписанную историю происхождения». Дальше — детали
Что работает на извлечение: определение в первом абзаце раздела, таблица там, где вопрос сравнительный, пошаговая инструкция там, где вопрос процедурный, короткие самостоятельные ответы в конце. Что не работает: превращать каждую страницу в набор таблиц ради нейросети. Формат выбирается под задачу читателя, иначе получается тот же спам, только под новый алгоритм.
Факт вместо рекламного утверждения
Модели нечего процитировать в предложении «мы одна из лучших компаний». Ей есть что процитировать в предложении с числом, датой и проверяемым списком: столько-то объектов за год, такая-то площадь, вот перечень с адресами. Проверяемое утверждение цепляется к сущности компании, рекламное — нет.
Отсюда же ценность собственных данных. Десять сайтов пересказывают одно и то же — у модели нет причины выбрать ваш. Свой замер, своя статистика, свой разбор цен по рынку — источник, которого больше нет ни у кого, и именно он цитируется.
Прежде чем писать очередную обзорную статью, спросите: что в ней есть такого, чего нет в первых десяти результатах поиска. Если ответ «ничего», это материал для внутренней вики, а не для видимости в ответах.
Как мерить, чтобы не обманываться
| Метрика | Что показывает | Ступень |
|---|---|---|
| Доля извлечений | Как часто ваши страницы попадают в источники | 1 |
| Доля цитирований | Как часто показывают ссылку на вас | 2 |
| Доля упоминаний бренда | Как часто в ответе звучит название | 3 |
| Доля рекомендаций | Как часто вас предлагают как решение | 4 |
| Доля конкурентов | Кого называют вместо вас | 4 |
| Источники ответа | Чьи материалы формируют мнение о вашем рынке | — |
| Переходы и что дальше | Сколько людей пришло и что сделали | — |
Одна метрика без остальных врёт. Рост извлечений при неподвижных упоминаниях означает ровно то, что случилось у Kimi: вы кормите ответ, в котором вас нет.
Мерить надо не по одному запросу. Формулировка меняет ответ, поэтому нужна матрица: информационные вопросы («сколько стоит», «как выбрать»), коммерческие («какие компании», «кого выбрать»), сравнительные («A или B»), репутационные («что известно о компании X»). И прогонять её регулярно в нескольких системах, потому что ответ нестабилен во времени.
Почему «наштамповать инструкций» — не стратегия
Кейс Kimi часто читают как рецепт: публикуй пакетами, попадёшь в источники. Это верно ровно наполовину и опасно второй половиной. Массовая публикация под алгоритм — старая история SEO, которая каждый раз заканчивается одинаково: система учится отличать полезное покрытие тем от штамповки, и штамповка обесценивается вместе с доменом, который её произвёл.
Полезное покрытие отличается от штамповки одним признаком: за каждой страницей стоит настоящий вопрос человека, на который на ней есть настоящий ответ.
Главное
Видимость в ответах нейросетей — это лестница из четырёх ступеней, а не переключатель. Своим сайтом вы поднимаетесь на две первые: техническая доступность и текст, из которого удобно достать ответ. На две верхние поднимают другие: независимые упоминания, обзоры, согласованные данные о компании в разных источниках.
Поэтому вопрос «как попасть в ChatGPT» стоит переформулировать. Правильный звучит так: что должно быть написано о нас в интернете, чтобы после чтения десятка источников модель сочла наш бренд частью правильного ответа.
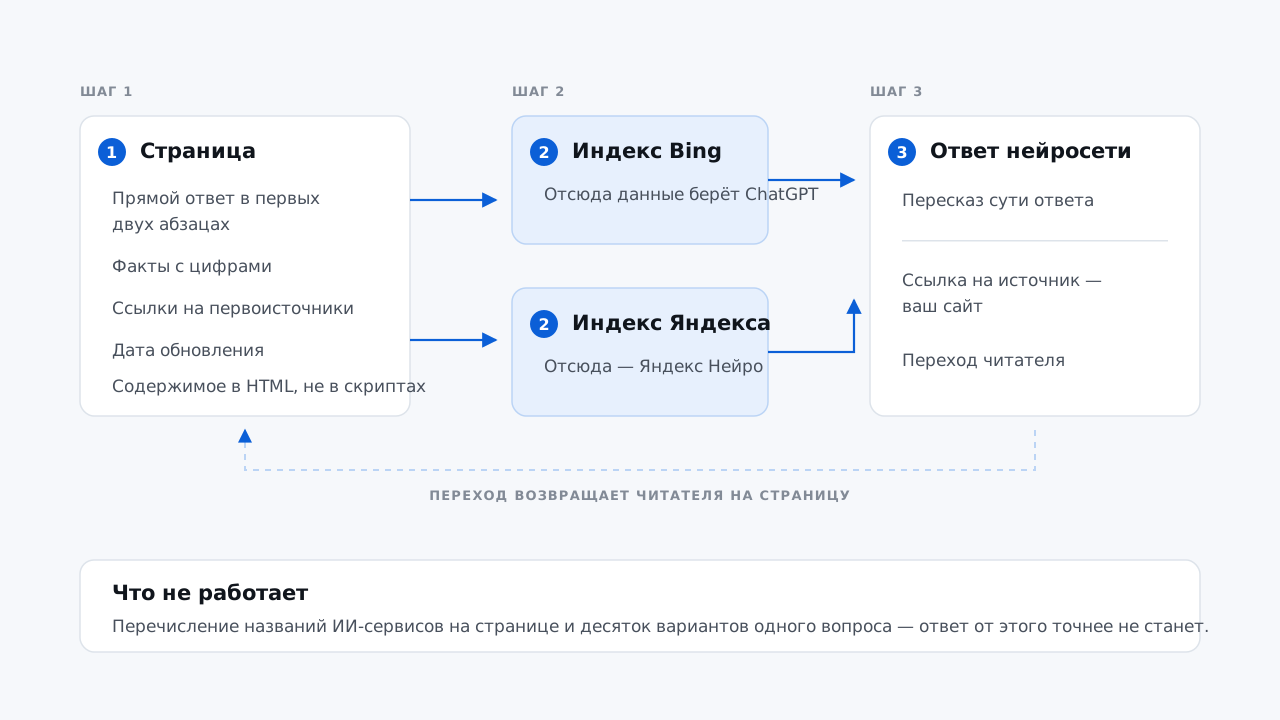
Как попасть в ответы ChatGPT и Яндекс Нейро
Продающий SEO-аудит: показать клиенту деньги, а не ошибки
Кого антибот режет по ошибке: YandexBot, ИИ-краулеры и полезные боты
Watermark в AI-тексте: как нейросети метят свои тексты и что эту метку стирает